
用本地端 AI 算力,生成一萬多個聲音
我最近做的幾個東西,剛好都很吃聲音。casper.tw 上的小遊戲要音效,口袋單字王每個單字要有發音,每句例句也都要有人念。YouTube 的情境故事影片就更多了,一集大概有一百五十句中英對話,身為一個超摳的開發者,自然要找些高 CP 值的方案。
這種量如果全部丟給雲端語音服務,費用就會一直往上加。所以這次我幾乎都直接在自己的 Mac 上跑,M4 Max、64 GB 記憶體。原因其實很單純:省錢,而且現在本地模型的品質其實也不錯。
一路做下來,單字王的音檔已經一萬多個,小遊戲的音效也正在接進遊戲裡。這邊主要跟大家分享我用什麼樣的方法,那也會附上一些生成的成果給大家試聽看看,那就給大家做個參考囉。
其實本地端就有不錯的成果
一開始我對這件事情也挺苦惱的,然後有上網找一些解決方案,像是免費的音效或者是像 Google 的語音生成。如果只有幾個音效,費用不太高;但是如果數量一多的話,那價格也是挺可觀的。
而「音效」跟「語音」,這兩種是不一樣的模型。
音效模型吃的是一段描述。像是你寫「小紙網輕輕放進淺水裡」,它就會生一段聲音。語音模型,也就是 TTS,吃的是文字,把它念出來,有些還能指定聲音、口音跟語氣。
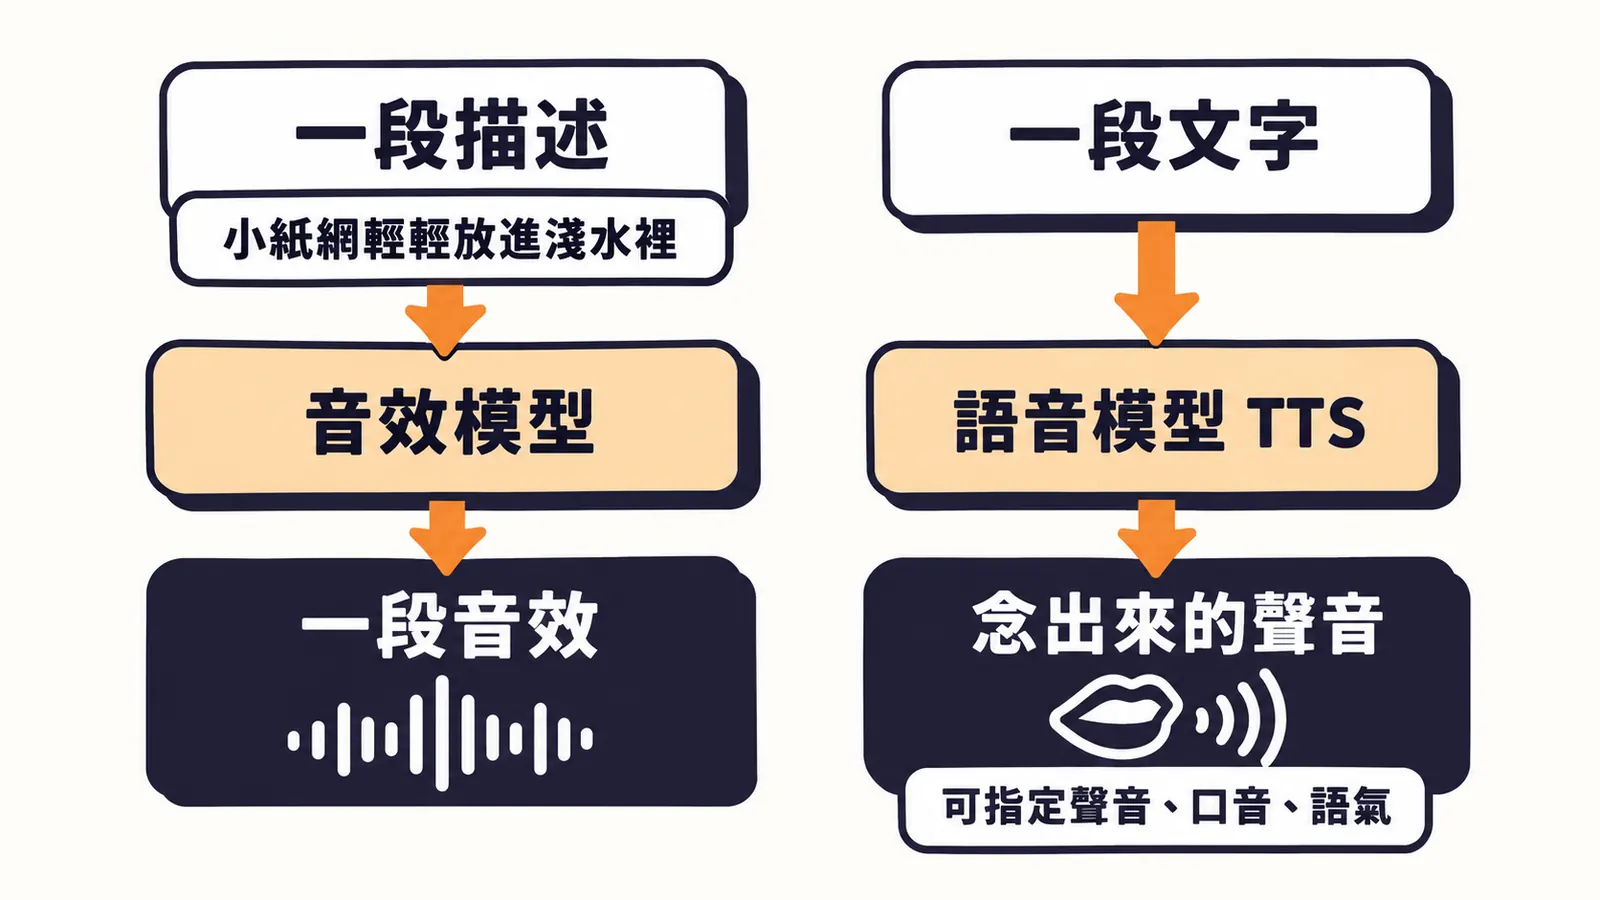
音效模型吃描述,語音模型吃文字。
我這次大概用到這些:
| 模型 | 類型 | 我拿來做什麼 | 在我 Mac 上的速度 |
|---|---|---|---|
| Stable Audio 3 Small-SFX | 音效 | 遊戲音效(只吃英文提示) | 幾秒一個 |
| MOSS-SoundEffect | 音效 | 遊戲音效(可以寫中文提示) | 一個音 4 到 20 秒 |
| Step-Audio-EditX | 語音 | 美式單字、大部分例句 | 念 1 秒要算約 0.8 秒 |
| Kokoro | 語音 | 英式單字(先念,再換聲);唯一能指定音標的 | 念 1 秒不到 0.1 秒 |
| Chatterbox | 語音 | 把 Kokoro 念的英式發音換成亨利的聲音 | 比較慢 |
| Qwen3-TTS | 語音 | 設計角色聲音、部分角色的例句、故事影片的英文和中文 | 念 1 秒約 0.2 秒 |
| VoxCPM2 | 語音 | 設計角色聲音 | 念 1 秒約 1 秒 |
| BreezyVoice | 語音 | 做台灣腔中文的參考音 | 只錄幾句,沒有特別量 |
| Whisper | 語音辨識 | 把音檔轉回文字,檢查有沒有念對 | 沒有特別量 |
標深色字的是我覺得使用上品質還不錯的
還有一件很重要的事:**AI 自己聽不到聲音。**它可以幫我寫腳本、一次生一大堆、量音量、跑語音辨識,但這個聲音到底好不好聽、像不像那個角色,我建議還是真人自己聽會比較好。
遊戲音效先大量生,再用耳朵挑
小遊戲這邊,我用了兩個音效模型:Stable Audio 3 Small-SFX 和 MOSS-SoundEffect。Stable Audio 3 只吃英文提示,但速度很快,幾秒鐘就能生一個;MOSS-SoundEffect 可以直接寫中文,不過一個音大概要跑 4 到 20 秒。
我的做法是先列一份清單,然後直接讓 Claude 幫我撰寫相關的提示詞。Claude 會幫我寫不同的版本,然後讓 AI 進行生成。
前面的步驟其實還挺快的,但是後面的話需要真人去聽,就會花上許多時間。我請 Claude 做了一個 Artifact 挑選頁,一個音一張卡片,每張卡片上放好幾個候選。聽完覺得可以就按「選這個」,都不行就按「要重生」,然後留一句備註,像是「稍微小聲一點」。下一輪就照我的備註改提示詞,再重新生一次。
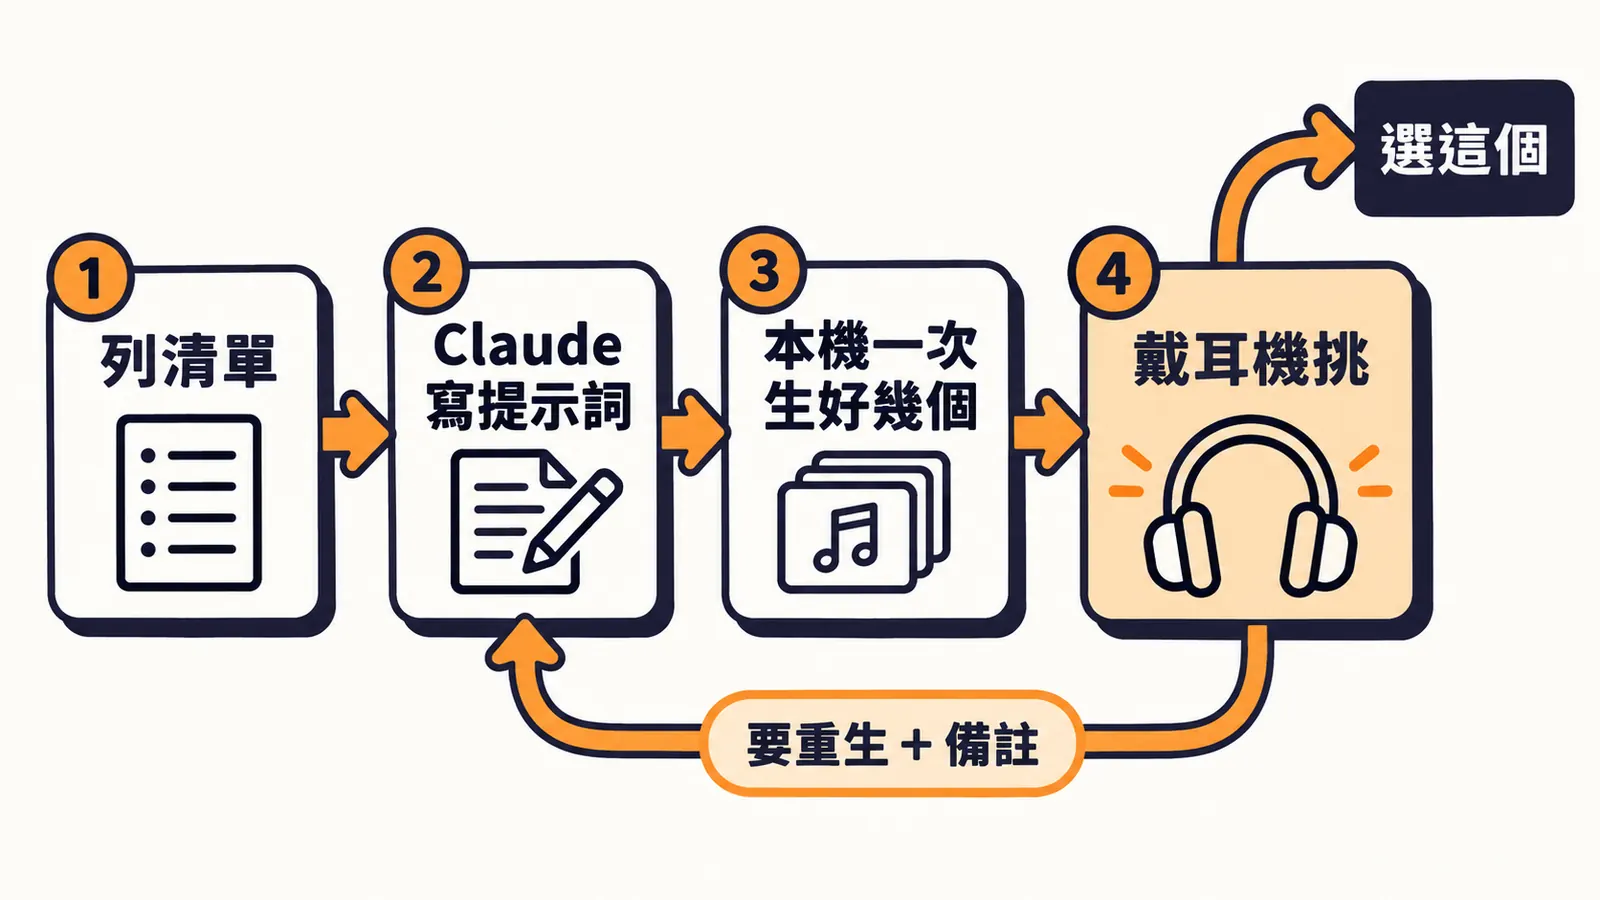
挑不到滿意的就留備註重生,回到寫提示詞那一步。
飛天跑車的「噴氣一下」就是一個例子。第一輪的提示詞是「短促的壓縮空氣噴射聲,像小火箭推進器噴一下」,第二輪改成更短、半秒左右就結束的「噗嘶」一聲。結果最後選中的,反而是另一張卡「按住持續噴氣」第一輪生出來的候選,它的提示詞明明是「持續的火箭推進器噴射聲」。挑選頁可以把別張卡的候選借過來用,所以就直接拿它來當噴氣一下:
後來「按住持續噴氣」的循環音,也是從這一段切開頭一小段出來做的,這樣按一下跟按住的聲音才會是同一種音色。
飛天跑車還有一些音是要一直循環的,像在天上飛的風聲。這種循環音最怕接縫,每播一圈就「喀」一下。
這裡我用了個小技巧:從生好的風聲裡切一段比較穩的地方,先正著播一次,再倒著播一次接起來。風聲倒著播其實根本聽不太出來,接點也剛好能連在一起。下面這段是同一段循環播三圈:
當然也有踩坑。Stable Audio 3 要求的長度如果太短,例如 1.2 秒,整段就會爆音,換提示詞也沒用,最後我就一律生成 3 秒在進行合成微調。
單字發音,念對比好聽重要
口袋單字王是我在做的多益單字遊戲,每個字都要有美式跟英式發音,例句也要有人念。這邊我前後比了五、六個 TTS 模型。
第一輪先比 Kokoro 跟 Chatterbox。Kokoro 很穩,但我聽起來音質「不夠頂」;Chatterbox 好一些,可是真的很慢。第二輪又把 Qwen3-TTS、VoxCPM2、Step-Audio-EditX 一起拉進來比。
真人發音除了要唸對之外,其實我覺得感覺很重要,所以我花了很多時間去調整每個角色唸出來的音質感受。
下面是同一個字 negotiate,換成不同角色來念,都是 Step-Audio-EditX 照各自的聲音念的:
單字還有一個問題是吃音。單字單獨念的時候,itinerary 的開頭、schedule 的結尾,很容易直接被吃掉。後來的解法是,先把單字放進一句話裡念,再把那個字切出來。
最後的組合是這樣。美式單字跟大部分例句,我比較喜歡 Step-Audio-EditX 的聲音,所以就用它照角色的聲音來念。英式就比較曲折,英式發音的亨利一開始念出來大多是美式口音,最後改成先讓 Kokoro 用英式念,再用 Chatterbox 把聲音換成亨利的。
下面是同一個 schedule,先美式的米亞,再英式的亨利:
因為 AI 聽不到聲音,所以角色音色是我人工聽的,但我不太可能去對每一個發音的單字,所以我在這個裝置裡面還安裝了 Whisper,透過 Whisper 去辨識這些發音正不正確。
整集英文對話,連台灣腔中文都在本機做
YouTube 的情境故事影片,每集是一男一女的中英對照對話,一句英文接一句中文,一集四十到六十分鐘,到現在已經做了十幾集。
中文要有台灣腔。直接請模型「用台灣腔念」其實不太穩,所以最後做成兩段式:先用聯發科的 BreezyVoice,拿角色原本的音色錄一句台灣腔中文當參考,再讓 Qwen3-TTS 照著這句參考,念完所有中文台詞。
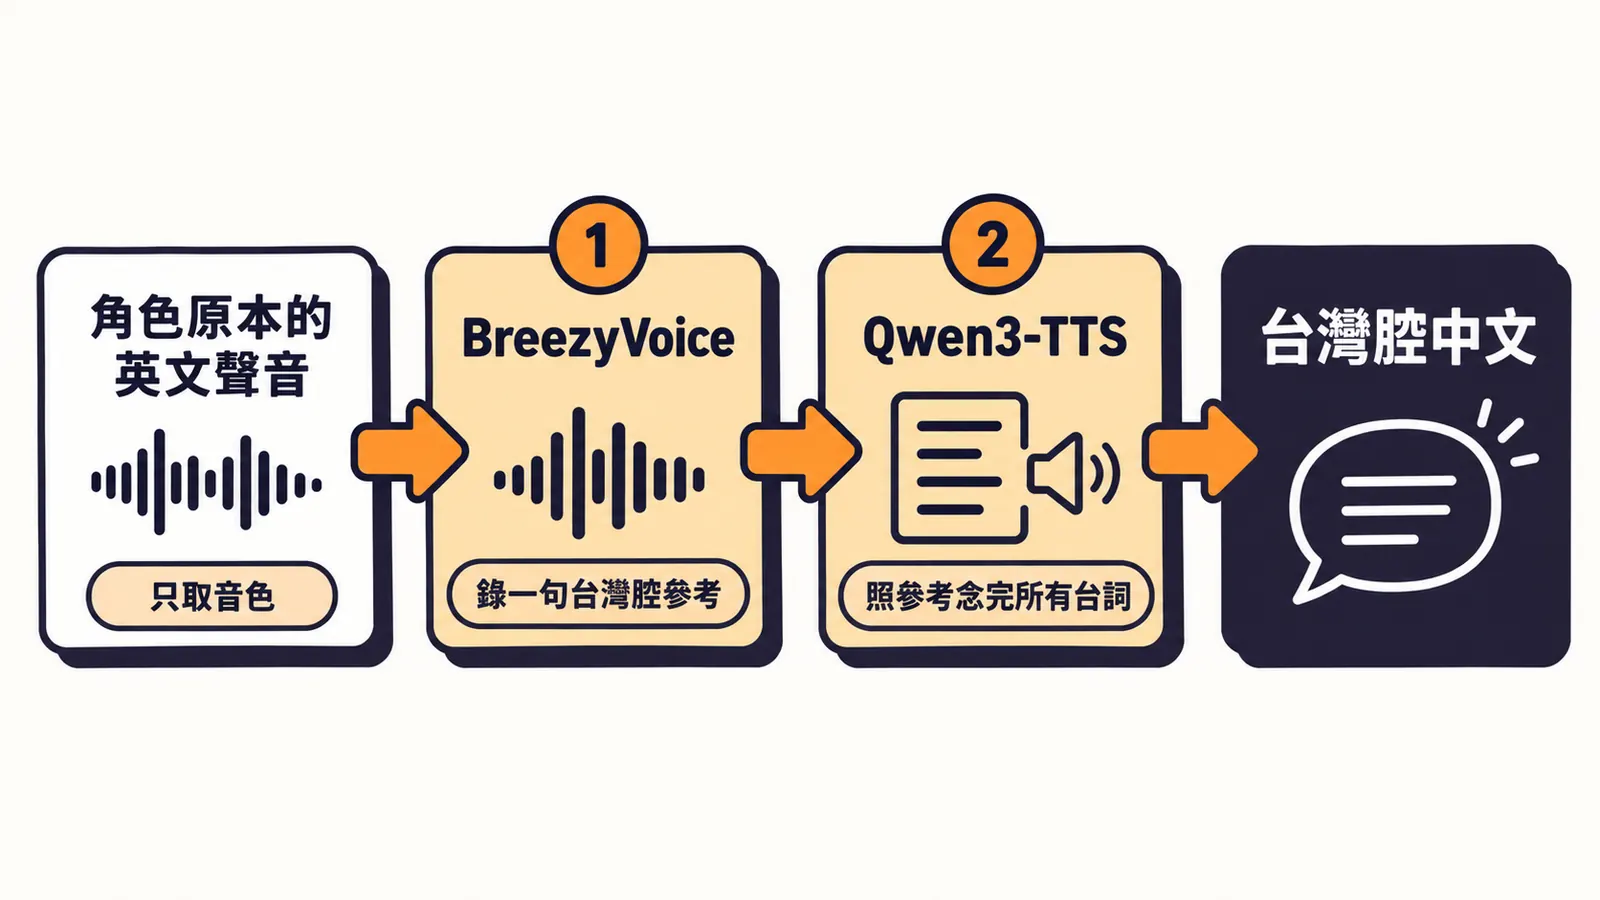
台灣腔中文分兩段:BreezyVoice 先錄一句參考,Qwen3-TTS 再照著念完全部台詞。
試聽了六輪,我的結論是:「看來是 QWEN 幾乎全勝,如果沒有情緒,就是很穩的台灣腔調。」
下面是第二集《老外遊台北》裡的一句。台灣女生喬伊帶美國朋友班去飲料店,教他怎麼點珍奶,同一個角色先英文,再台灣腔中文:
不過中文也會有一些問題,像是這個模型是中國的模型,所以雖然我可以把它改得比較偏向台灣腔,但是用詞的發音呢,還是會略有不同。
另外,在剪輯的過程中,也常常會有破音的狀況,有些時候就需要人工去聽。
散熱會是一個瓶頸
因為在跑這些語音檔的時候,它會吃掉滿多的效能,所以我通常會在半夜的時候跑。
而半夜跑其實也會有一個額外的問題:我放 MacBook 的地方是不會開冷氣的,所以就會顯得機體非常燙。在運作過程中,我會請它休息一小段時間之後再繼續跑,所以每天晚上可以跑的量也是相當有限的。
跑一段、休息一段,每晚能跑的量有限。
但整體來說,這樣生成還是非常划算。因為如果是去註冊 Google 的語音服務,或是遊戲的音效生成,這些都需要額外的費用,大量生成的成本很高。
如果是採用本地端的方式,你可以請 Claude 或是 ChatGPT 來幫你先撰寫提示詞,並生成這些音效檔。你要做的事情,就只要負責一直聽、一直篩選你想要的成果就可以了。