YouTube 字幕怎麼切成句子:英文跟讀的斷句與 CEFR 分級
最近我做了一個練英文的小工具:英文跟讀 ↗。用法很簡單:貼上一支 YouTube 影片的連結,它會把英文字幕切成一句一句,每句標上難度。你可以只重播其中一句,錄下自己跟著唸的聲音,最後再用排序和拼字小遊戲複習。
難度用的是 CEFR(歐洲語言共同參考架構)。它把語言程度分成六級:最簡單的是 A1、A2,中間是 B1、B2,最難的是 C1、C2。
動手之前,我以為最難的會是控制播放器。做了才發現,最花時間的是兩件聽起來很無聊的事:字幕怎麼切成句子,還有一句話算幾級。這篇把實際的規則攤開來講,文中的比例和次數,都是開發時拿真實影片量出來的。最後也會說明,為什麼這個工具刻意不給發音分數。
字幕的一行,不等於一句話
YouTube 的字幕是一行一行出現的,每一行都有自己的開始時間(程式裡叫 cue,下面我都叫它「字幕行」)。最直覺的做法是一行當一句。問題是,字幕行是照畫面放得下幾個字、或講者在哪裡停頓來換行的,不是照句子切的。一句話常常跨兩三行,也常常在一行的中間就講完了。
舊版就吃了這個虧。當時我以為自動字幕沒有標點、沒辦法斷句,所以乾脆一行當一句。其實 YouTube 現在的自動字幕大多有標點,只是句尾常常落在一行的中間。我拿一支 TED 影片的自動字幕來數(後面的截圖用的也是這支):整份有 456 個句尾標點,只有 166 個剛好在行尾。結果那支影片的「句子」只有兩成以句號結尾,其他都是被攔腰切斷的半句。
現在手動字幕和自動字幕走同一套流程。先清掉 (Laughter)、[Music] 這種不是台詞的標記,再分四步處理:
- 在每一行裡找句尾:看到句尾的標點,就把這一行切成幾段。
- 把片段接成句子:一段一段往下接,接到真正的句尾就收成一句。
- 太短的句子併進前後句:少於 5 個字,不適合拿來跟讀。
- 最後清理:拿掉訪談字幕行首代表換人講話的
-號,還有Translator:這種字幕製作資訊。
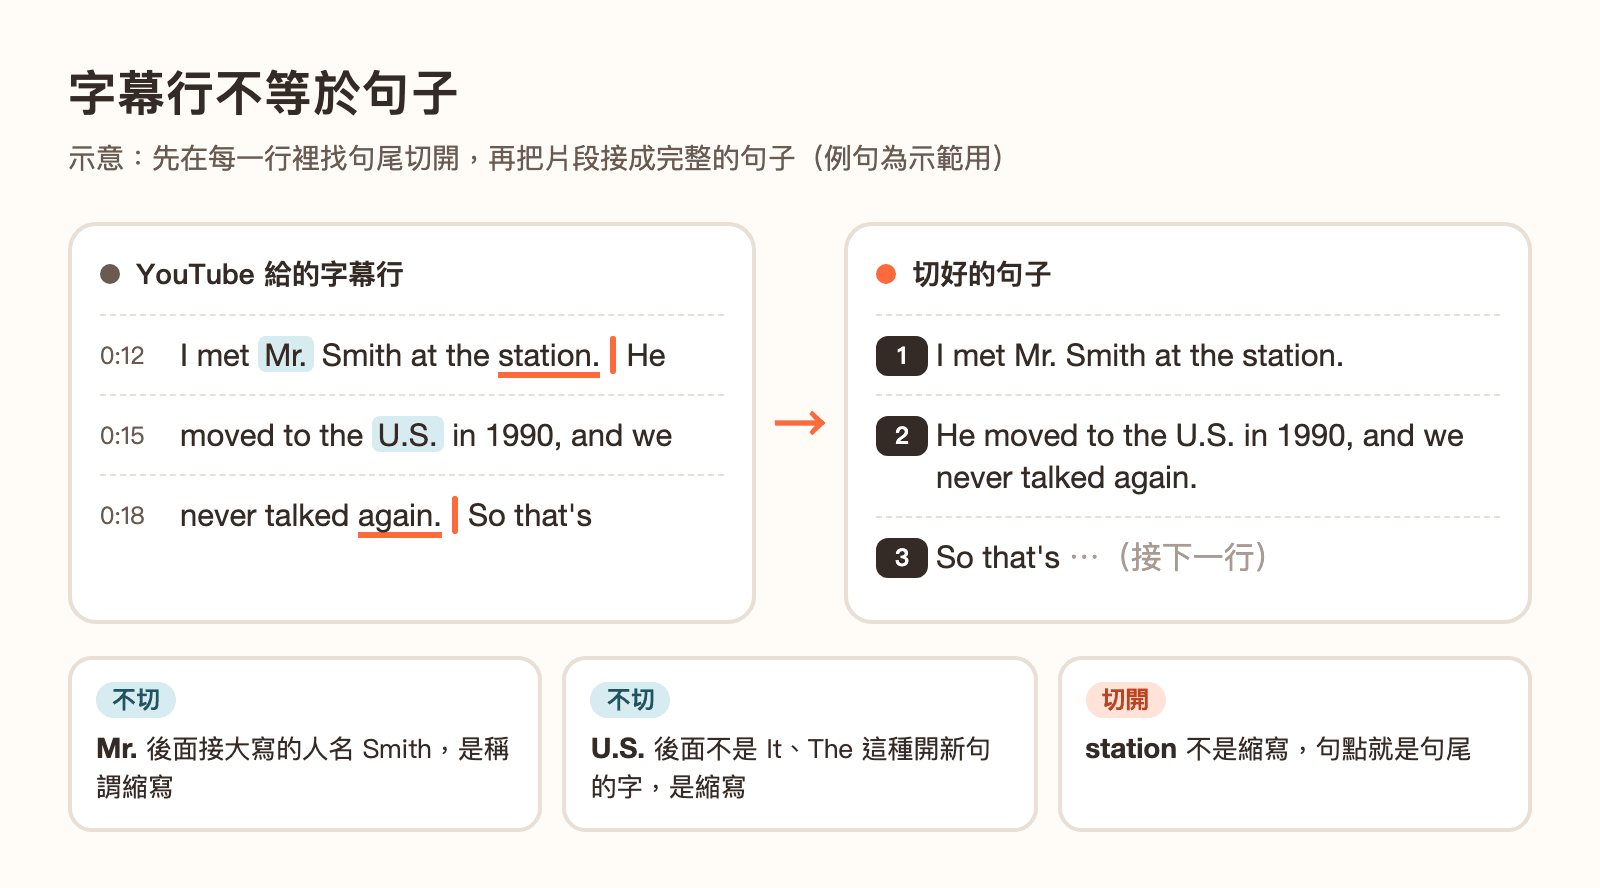
圖:字幕行和句子的對照示意。同一行裡可能藏著句尾,一句話也可能跨好幾行(例句為示範用)。
我拿六支影片比較改版前後(兩支自動字幕、四支手動字幕)。句子以句號結尾,大致代表它是完整的一句;這個比例整體從 66.2% 升到 94.5%,那支 TED 影片從 20.4% 升到 89.8%。
句號不一定是句尾:縮寫怎麼判斷
如果「看到句號就切」,第一個會踩到的雷就是縮寫,像 Mr. Smith、U.S. Senate、No. 5。這些句點後面,話明明還沒講完。
程式是一個單字一個單字看:只有結尾是句點的單字,才會被拿來判斷,而不是在整串文字裡找句點。所以 stanford.edu、3.5 這種句點夾在中間的字,根本不會被檢查。剩下的規則有這幾條:
- U.S.、e.g.、a.m.:這種「一個字母一個點」、至少連續兩組的縮寫,不切。例外是下一個字是 It、The、But 這種幾乎一定是新句子開頭的字,這時還是要切。
- No.、Vol.、p.:後面接數字才算縮寫。我測試用的字幕裡,No. 出現 14 次,全都是「不」的意思,沒有一次是「第幾號」。
- Mr.、Dr.,還有月份、星期的縮寫:後面接大寫或數字,才算縮寫。
- etc.、vs.、Inc.:一律當縮寫。
- 刪節號:下一個字是大寫開頭,才算句尾。所以
which is not often ... thankfully不會被切開。
另外有兩條規則,看起來很合理,實測卻是弊大於利,所以我刻意不做。
第一條是「句點後面接小寫,就不切」。這條規則的想法是:新句子一定大寫開頭,所以句點後面接小寫,就代表話還沒講完。但我的測試字幕裡只出現三個真正的縮寫,後面接的全是大寫的專有名詞(像 Mrs. Lynne、U.S. Senate),這條規則一次都沒派上用場。反過來,它還把自動字幕裡 8 個真正的句尾誤判成不用切,因為語音辨識不保證新句子一定大寫開頭。
第二條是「單一字母加句點,就是縮寫」。問題是英文的 I 就是單一字母。如果這樣判斷,you and I. 後面那一句會整個被黏上來。
講者一直不講完一句,怎麼辦
有些人講話可以拖二三十個字都不下句點,對話類的影片特別常見。一句太長根本唸不完,所以我設了上限:接到 28 個字或 15 秒,就先收成一句。兩行字幕之間如果空白超過 3 秒,也直接切開。
問題是,撞到上限時要切在哪裡?原本是撞到就切,常常切在很怪的地方。例如切成 …because well, it might be,下一句只剩一個 uncomfortable.。
現在的做法是:句子接到 24 個字以後,就允許在「子句的交界」收尾。子句是句子裡自己有主詞和動詞的一小段;交界指的是逗號、分號的後面,或是 I、you、because、but 這種常用來開始新子句的字前面。切在這種字前面,下一句就會從一段完整的話開始。
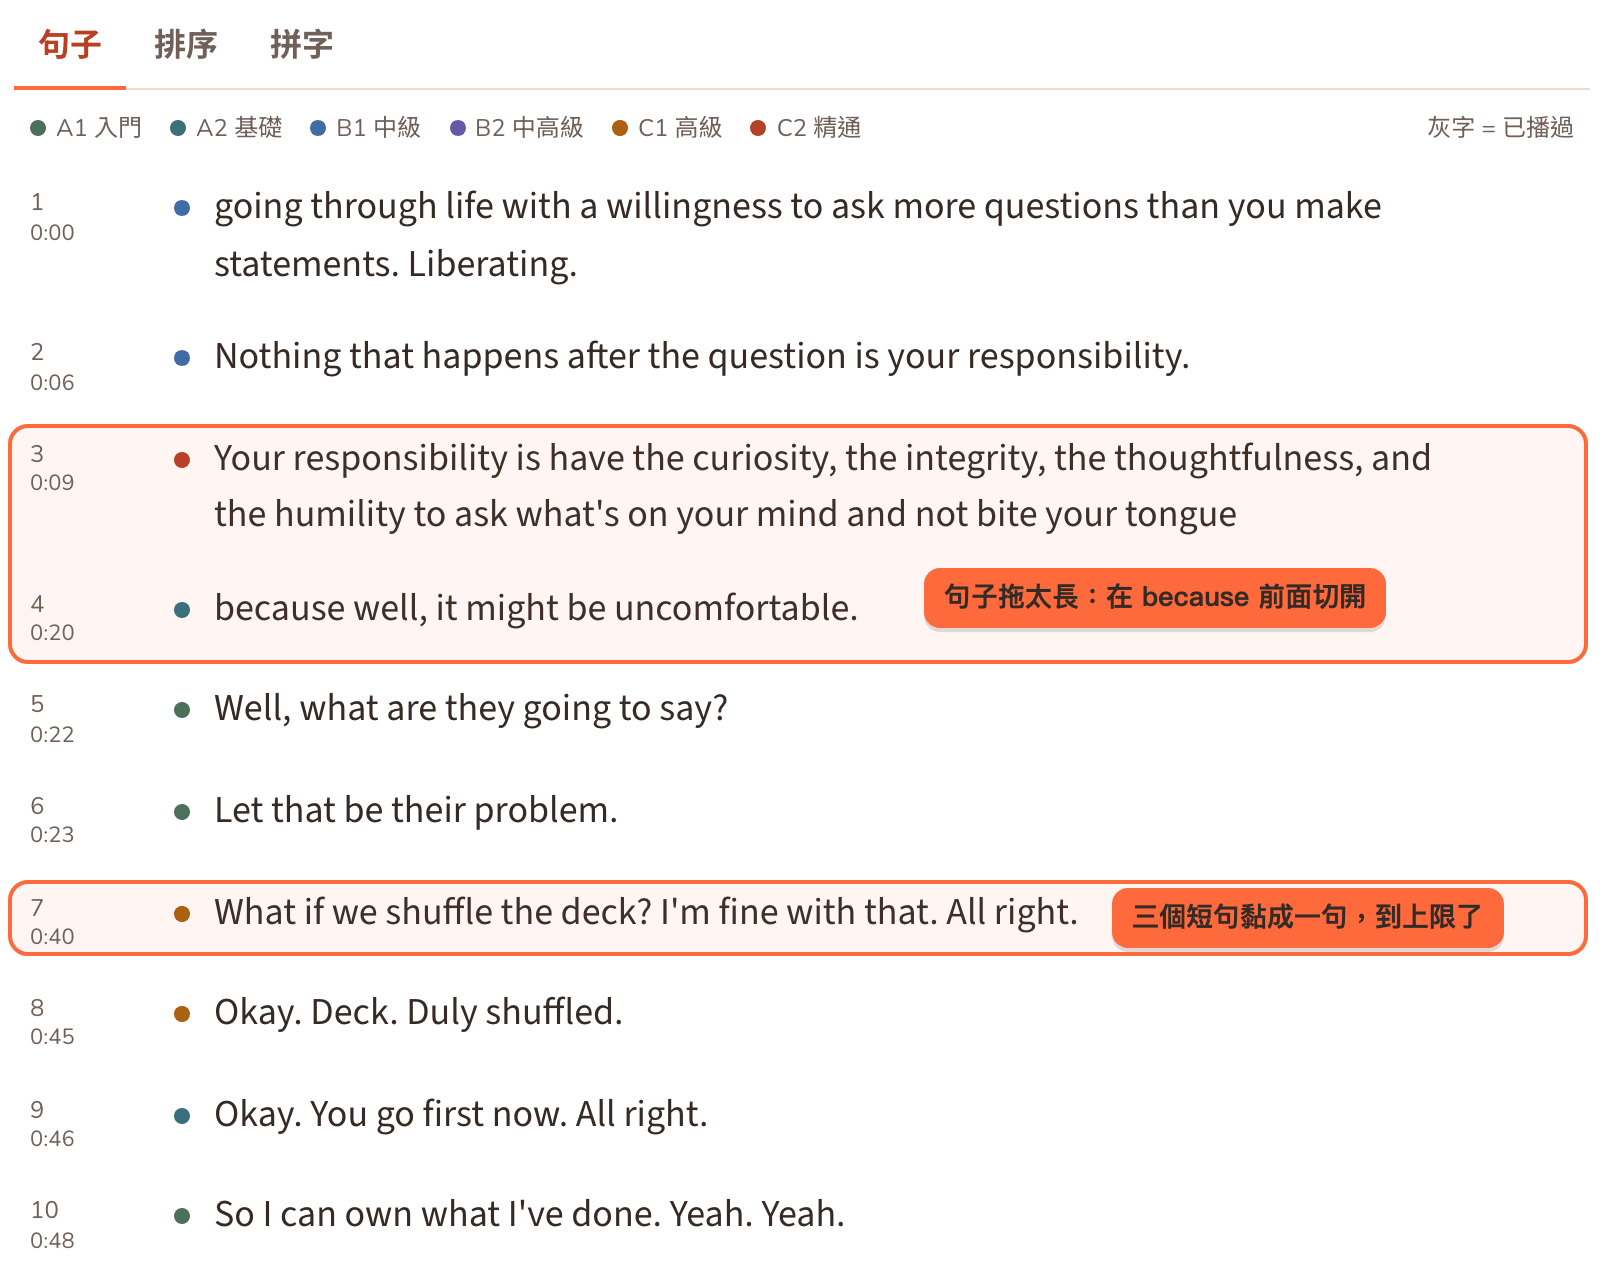
圖:同一支 TED 影片的練習頁。第 3、4 句就是上面那個 because 的例子,現在改在 because 前面切開。第 7 句是三個短句黏成一句,下一節會說明。句子前面的色點代表 CEFR 等級。
這條規則還會先往後看:要確定撞到上限之前都不會遇到句點,才用子句切點。不然本來再三五個字就會講完的好句子,會被提早切開。
門檻要設多少,真的需要取捨。同樣拿那六支影片來比:
| 從第幾個字開始允許子句切點 | 以句號結尾 | 切在半路 | 超過 28 個字 |
|---|---|---|---|
| 不用子句切點 | 96.2% | 34 句 | 95 句 |
| 24 字起(目前) | 94.5% | 9 句 | 47 句 |
| 18 字起 | 93.9% | 3 句 | 23 句 |
字幕是一段一段接上去的,最後接上的那段如果比較長,句子還是會超過 28 個字,表格最後一欄算的就是這種句子。
門檻愈低,被切在半路的句子愈少,但完整句子的比例也愈低,沒有兩全其美的設定。我一開始設 18。後來發現手動字幕本來就很少切在半路,設 18 反而讓它以句號結尾的比例從 97% 掉到 90%,付了代價卻沒換到好處,所以才放寬到 24。我也試過「遇到逗號一律切」,結果以句號結尾的比例直接掉到 83%。原因很簡單:停在逗號的句子,本來就不是完整的句子。
太短的句子與沒有標點的字幕
前面提過,少於 5 個字的句子會併進前後句。要往哪邊併,看標點決定:
- 前一句沒有句尾標點,代表它還沒講完,就往前併。
- 這一句自己沒有句尾標點,代表它是下一句的開頭,就往後併。
- 兩邊都是完整的句子,就併進時間比較接近的那一邊。
這裡我踩過一個雷:短句會一路往上黏。實測有一句把九句對話黏在一起,變成 What if we shuffle the deck? I'm fine with that. All right. Okay. …。問題不在字數,而在句數,所以我改成一句最多只能黏三個完整的句子。上一節截圖的第 7 句,就是這段對話現在的樣子:黏到三句就停下來。
另外,不是每條自動字幕都有標點。我總共測過 18 條字幕(前面那六支影片的字幕,再加上另外 12 條),其中 3 條一個標點都沒有。程式會算「每一百個字裡有幾個句尾標點」,低於 1.5 就當作沒有標點。有標點的字幕,這個數字落在 6.57 到 13.33 之間,離門檻很遠,不太會誤判。
沒有標點的字幕,就維持一行一句。YouTube 的自動字幕大致會在講者停頓的地方換行,沒有標點時,換行是唯一靠得住的線索。硬把好幾行併成一句,反而會跨過說話的停頓。
時間軸:自動字幕反而比較準
每一句都要知道從第幾秒開始播。這一點,自動字幕反而比手動字幕準。
自動字幕的每個字都帶有時間,所以從一行中間切出來的句子,開頭時間是準的。手動字幕整行只有一個開始時間,行中間的切點只能照文字長度按比例推算,例如切點在這行文字的一半,就當作這行的時間過了一半。這樣推出來的時間,誤差的中位數大約 0.3 秒,而一個英文字唸出來的長度,中位數只有 0.24 秒。不處理的話,句子的第一個字就會被吃掉。
所以每一句都會記下「開始時間是不是推算出來的」。如果是推算的,播放時就提早 0.25 秒開始。
一句話算幾級:CEFR 分級
每支影片收進來時,網站的伺服器程式就會先把等級算好(這支程式是 Cloudflare Worker,跑在 Cloudflare 的雲端上)。這一步不找任何 AI 模型幫忙,只是一組固定的規則,所以同一份字幕,永遠會算出同一個結果。整個流程由小到大分四步:
字表:我用的是開源的 wordfreq 3.1.1,它記錄了每個英文字有多常出現,再照這個常見程度把單字分成六級。常見程度用一個叫 zipf 的數字表示:數字愈大愈常見,每多 1,出現次數就多十倍。5.3 以上是 A1,4.8 以上是 A2,4.3 以上是 B1,3.8 以上是 B2,3.3 以上是 C1,2.8 以上是 C2。
單字:每個字會先照原本的樣子查一次,再粗略還原成原形查一次(例如去掉複數的 s、過去式的 ed、進行式的 ing、副詞的 ly、比較級的 er),查到的結果取最簡單的那一級。所以 curiously 在字表裡雖然是 C2,還是會跟 curious 一樣算 B1。句子中間大寫開頭的字,當作人名、地名這類專有名詞,不算分。字表裡查不到、又有 4 個字母以上的字,當成最難的一級。
句子:為了能加減,程式把 A1 到 C2 當成 0 到 5 分。先挑出句子裡最難的兩成單字,算出平均分數,再加上兩個修正,最後四捨五入就是這句的等級:
- 句長:以 12 個字為準,不加也不扣。字數愈多加愈多,到 24 個字加滿 1 分;比 12 個字短就扣分,最多扣 0.5 分。
- 語速:每分鐘 120 字以上加 0.25 分,150 字以上加 0.5 分,180 字以上加 0.75 分。不到 10 個字的句子語速估不準,只加一半。
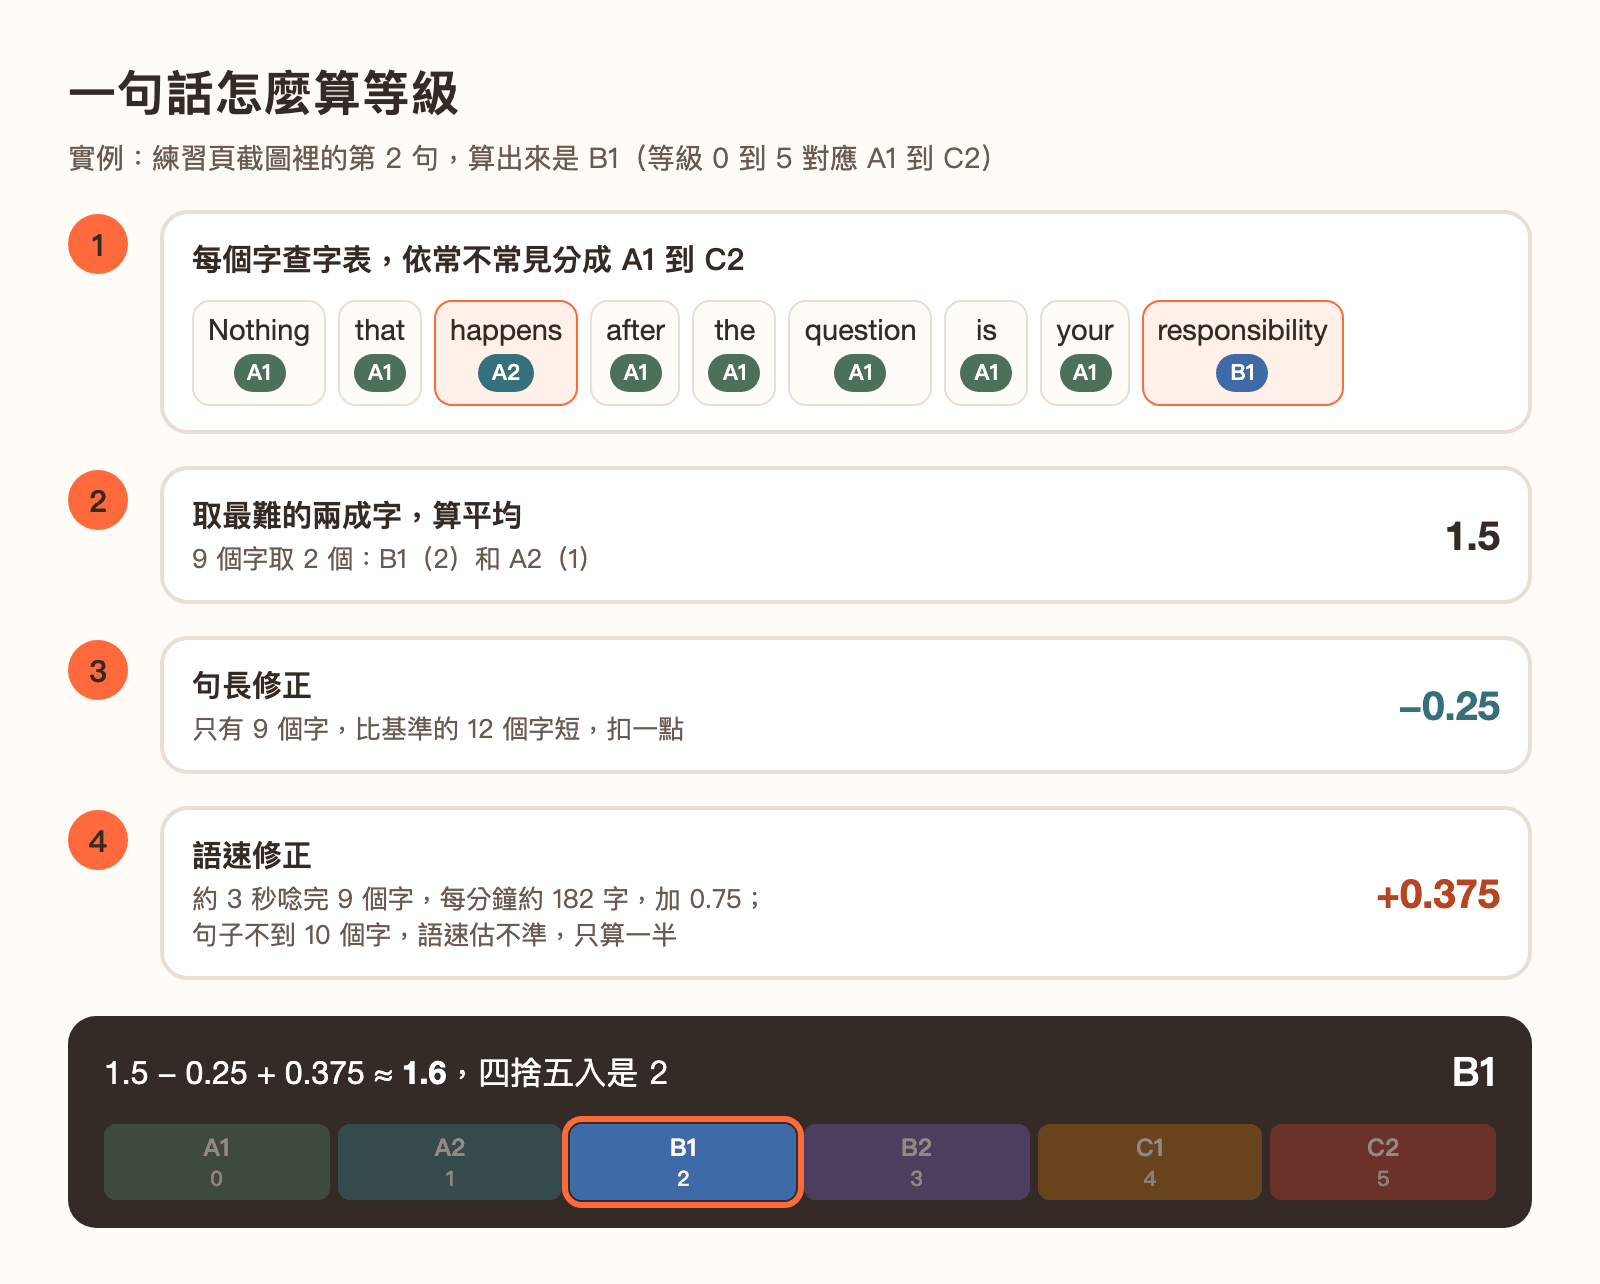
圖:拿前面練習頁截圖的第 2 句實際算一次:加起來約 1.6 分,四捨五入是 2 分,也就是 B1,跟截圖裡那句的藍點一致。
整支影片:從 A1 往上數,數到哪一級時影片裡 95% 的字都已經包含在內,那一級就是影片的單字等級。再加上平均句長和整體語速的修正;如果是自動字幕,另外多加 0.5 分,也就是半級。
標出來的等級只是估計
有件事一定要說清楚:這裡的 A1,指的是「最常見的 490 個字」,不是教材裡照 CEFR 分級整理的 A1 單字表。它只看一個字在大量文字裡出現得多頻繁,不管初學者是不是先學到它。所以 government、research、international 會落在 A1,eat、sleep、teacher、tomorrow 反而在 A2。
標出來的等級,是幫你挑影片用的估計值,不是檢定成績。以後如果要換成教學用的分級字表,只要照同樣的格式換掉那份字表檔(JSON),程式不用改。
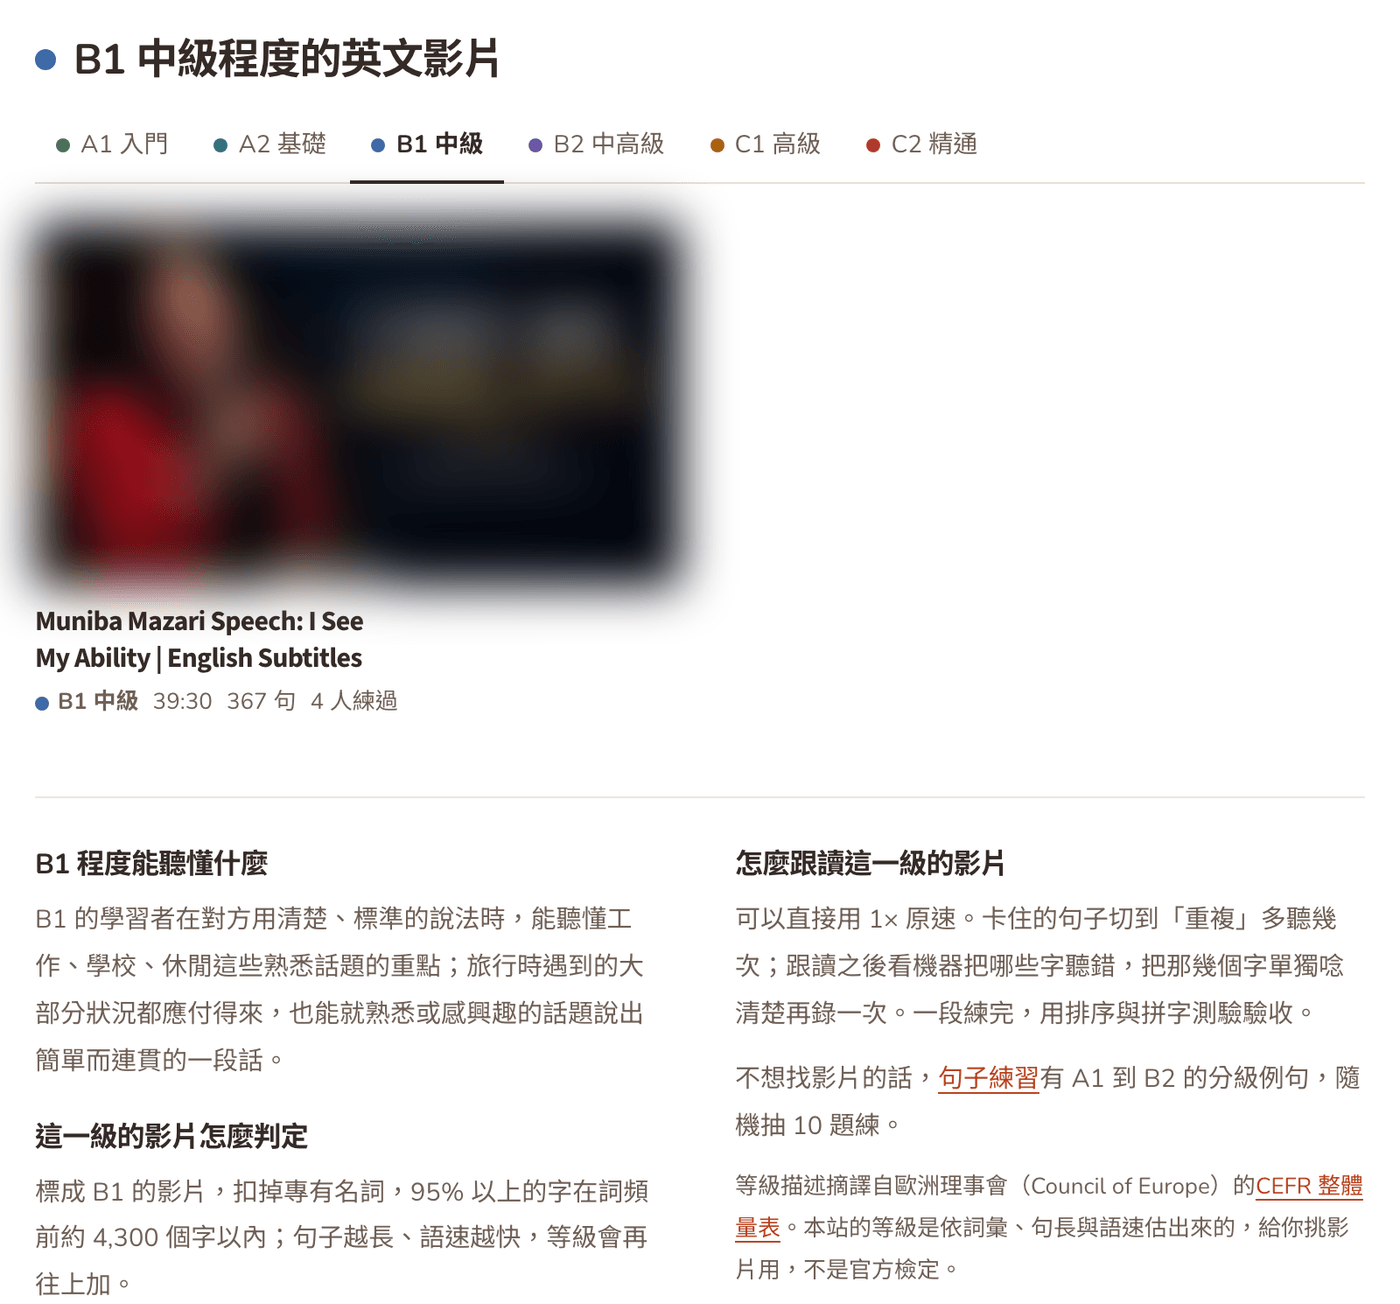
圖:B1 等級頁。「這一級的影片怎麼判定」寫的就是上面那條 95% 規則,旁邊也提醒這是估計值、不是官方檢定。影片縮圖已做模糊處理。
沒有音檔的句子:一個不會報錯的坑
還有一個很難發現的坑。工具裡另外有一個不用影片的「句子練習」。題庫的句子只有文字,沒有真人錄音,所以不知道一句要唸幾秒。可是前面的語速修正,偏偏需要這個秒數。
如果直覺地把唸完的時間寫成 0 秒,程式會把它拉到最低的 0.5 秒。十五個字除以 0.5 秒,等於每分鐘 1,800 字,語速修正直接加到最大的 0.75。結果題庫裡的句子都會平白多出語速分數,十個字以上的句子多 0.75 分,很多句子因此多算一級,程式卻不會報錯,也沒有任何警告。
解法是替這些句子編一個假的唸完時間,照每分鐘 100 字來算。語速修正的第一個門檻是每分鐘 120 字,所以這些句子的語速修正永遠是 0。產生題庫的腳本每次啟動時也會自我檢查:把假時間改成十倍長,分數必須一模一樣;分數要是變了,就代表語速又偷偷被算進去了。
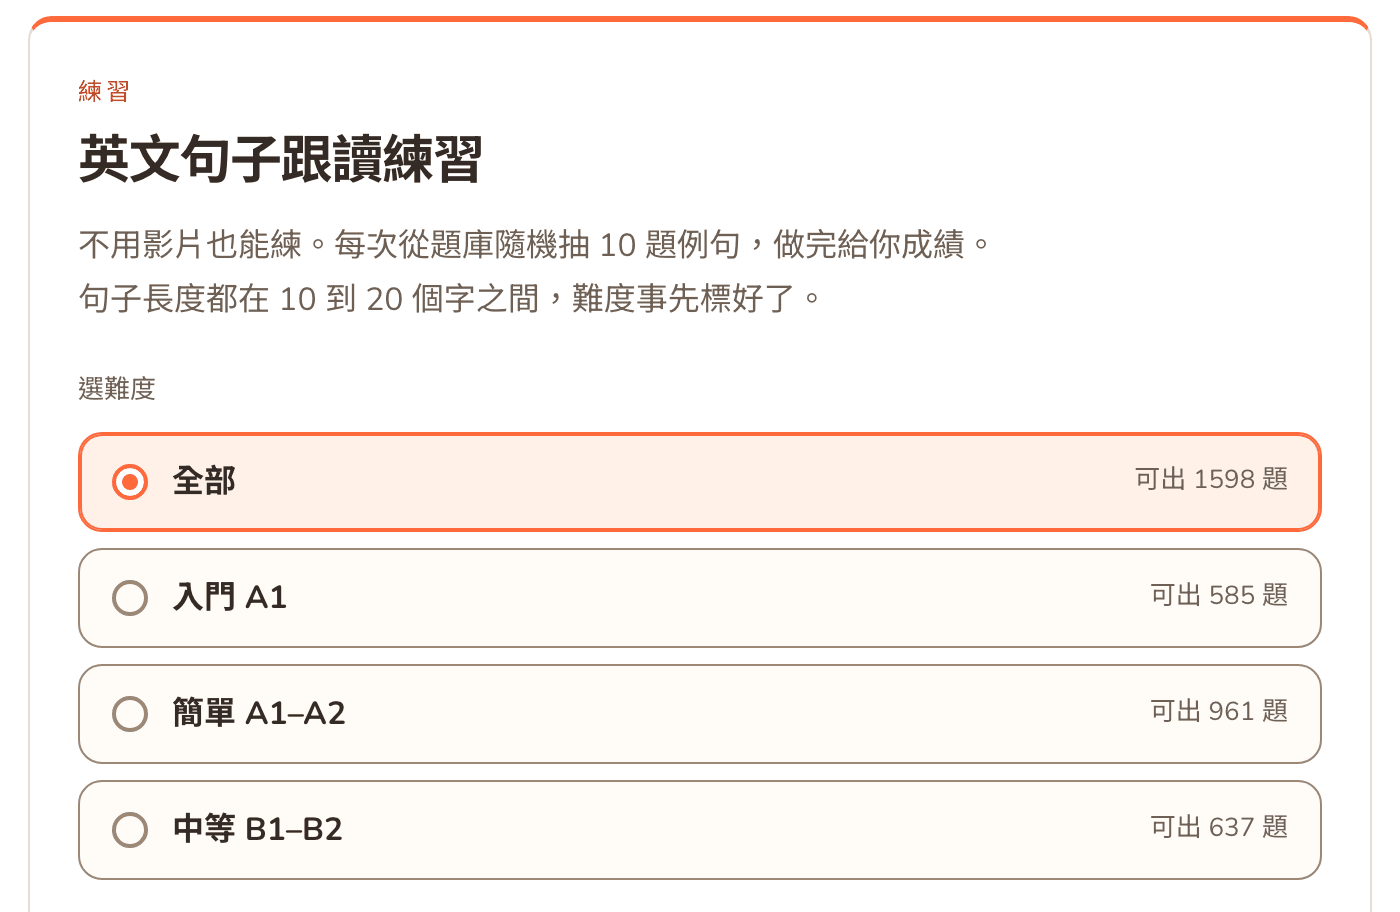
圖:句子練習的難度選單。入門、簡單、中等這些分類,用的就是同一套規則算出來的等級。
為什麼不給發音分數
按下跟讀後,瀏覽器內建的語音辨識會把你唸的話轉成文字(用的是 Web Speech API,網頁可以直接呼叫的語音轉文字功能)。程式再把這段文字跟原句一個字一個字對齊,標出哪些字一樣、哪些發音接近、哪些被聽成別的字,還有漏掉和多出來的字。但畫面上不會出現「發音 87 分」這種分數。
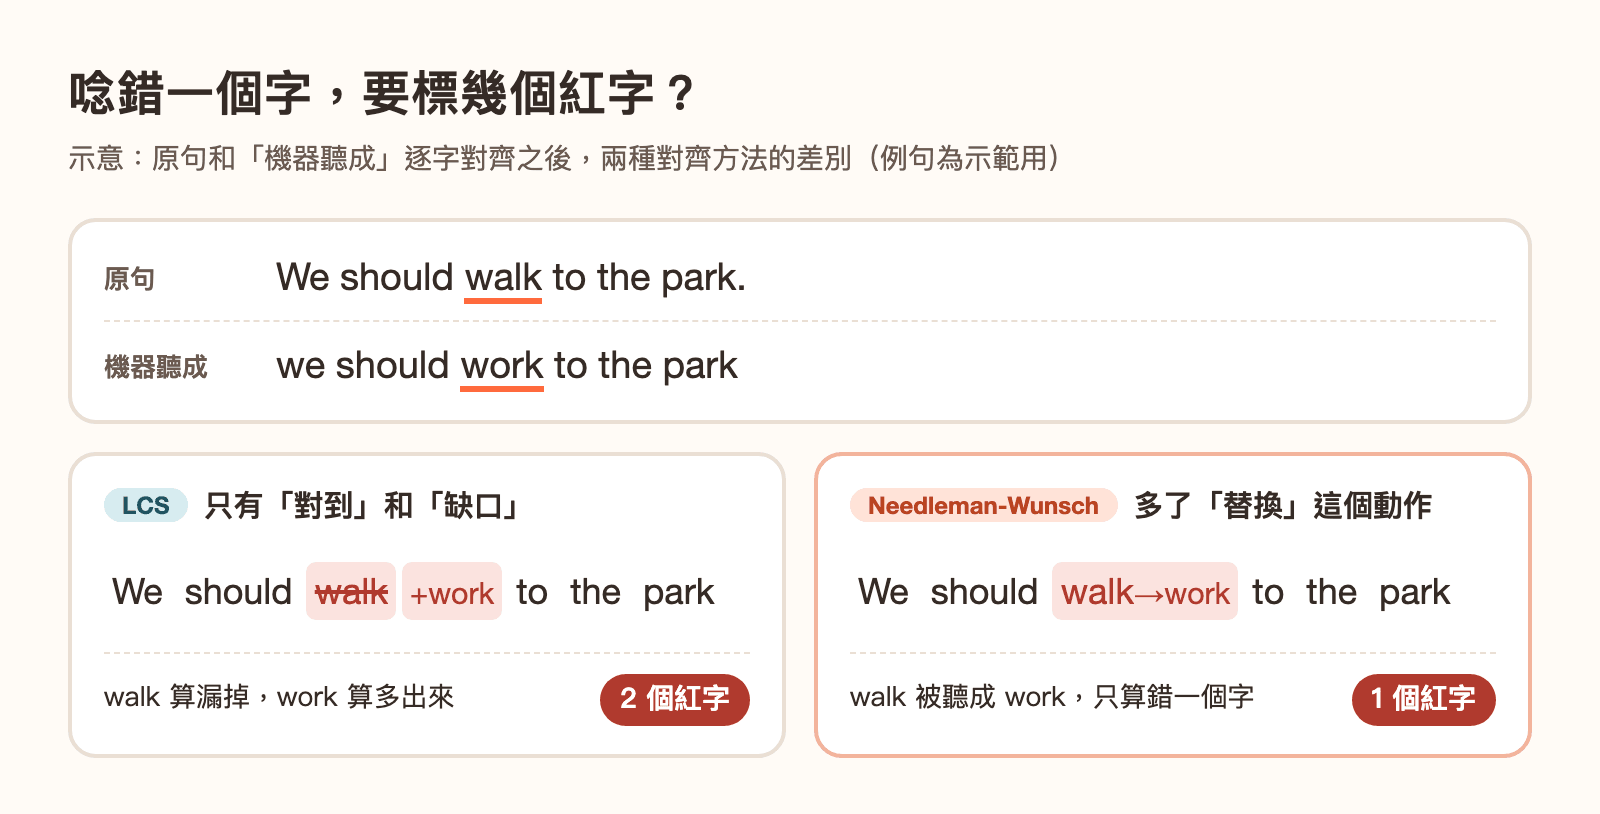
圖:唸錯一個字時,兩種對齊方法標出來的差別。工具用的是右邊這種(例句為示範用)。
不給分數的原因很單純。瀏覽器交給網頁的辨識結果只有兩樣東西:辨識出來的文字,和一個信心值。沒有音素(組成發音的最小單位),也沒有每個字的時間點。所以程式判斷不了你的 th 咬得對不對,也不知道重音落在哪個音節。拿這些資料算出來的發音分數,只會是編出來的數字。
也有研究發現,語音辨識軟體聽不聽得懂非母語者,跟真人聽不聽得懂,常常對不上(Derwing、Munro 與 Carbonaro,2000)。所以我把這個功能定為「可懂度檢查」:看機器聽不聽得懂你,而不是評你唸得標不標準。
照著這個想法,我還做了幾個決定:
- 不先把原句告訴辨識器:Web Speech API 可以先提示辨識器「等一下可能會聽到哪些字」。但這樣你唸錯時,它也可能聽成正確的字,回饋就不準了。
- 對到的字不到一半,就不逐字上色:改成整句提醒。這種情況通常是麥克風收音、環境噪音,或句子太長太快,不是你每個字都唸錯,滿畫面紅字只會誤導人。
- a、the、of 這種小字不特別標出來:這類幫忙組句子的功能詞,辨識器很常漏掉或多加。
- 兩邊用同一套規則整理:原句和辨識結果都會把 I'm 改成 I am、gonna 改成 going to、twenty five 改成 25、colour 改成 color,最後拿掉標點,才拿來比對。
給想看細節的人:對齊與錄音
- 對齊用 Needleman-Wunsch:這是一種把兩串文字逐字對齊的經典演算法。我沒沿用原本的最長共同子序列(LCS),因為 LCS 沒有「替換」這個動作。唸錯一個字,會被算成「漏一個、多一個」,紅字就變成兩倍,也就是上面示意圖左邊的情況。
- 錄音只留在瀏覽器的記憶體裡:換一句或離開頁面就丟掉,不會上傳到本站。錄音時也會關掉瀏覽器的降噪和自動音量調整。它們會削掉氣音、把音量拉平,剛好毀掉你想聽清楚的細節。
- 轉成文字那一步不在本站:用的是瀏覽器內建的語音辨識。在 Chrome 上,聲音會送到 Google 的伺服器處理。
完整字幕只在練習時載入
每支影片的公開頁面只放標題、摘要和大綱,完整字幕要按下「開始練習」才會載入。字幕是影片作者的內容,工具只是把它整理成好練習的樣子,不該變成讓人整份抓走的逐字稿。
小結
- 斷句看標點,不看字幕行:自動字幕現在有標點,在一行裡面找句尾,是這次改善最多的地方。
- 每條規則都拿真實字幕量過:會讓結果變差的規則,看起來再合理也不做。
- 分級用固定規則:同一份字幕永遠算出同一個結果,也老實說明它是詞頻估計,不是官方檢定。
- 給不出真的分數,就不給分數:把機器聽到的字攤開給你看,比一個編出來的數字有用。
工具在這裡:英文跟讀 ↗,免費、不用註冊,登入後可以跨裝置同步進度。想知道怎麼用它安排跟讀練習,可以看英文跟讀的工具介紹。